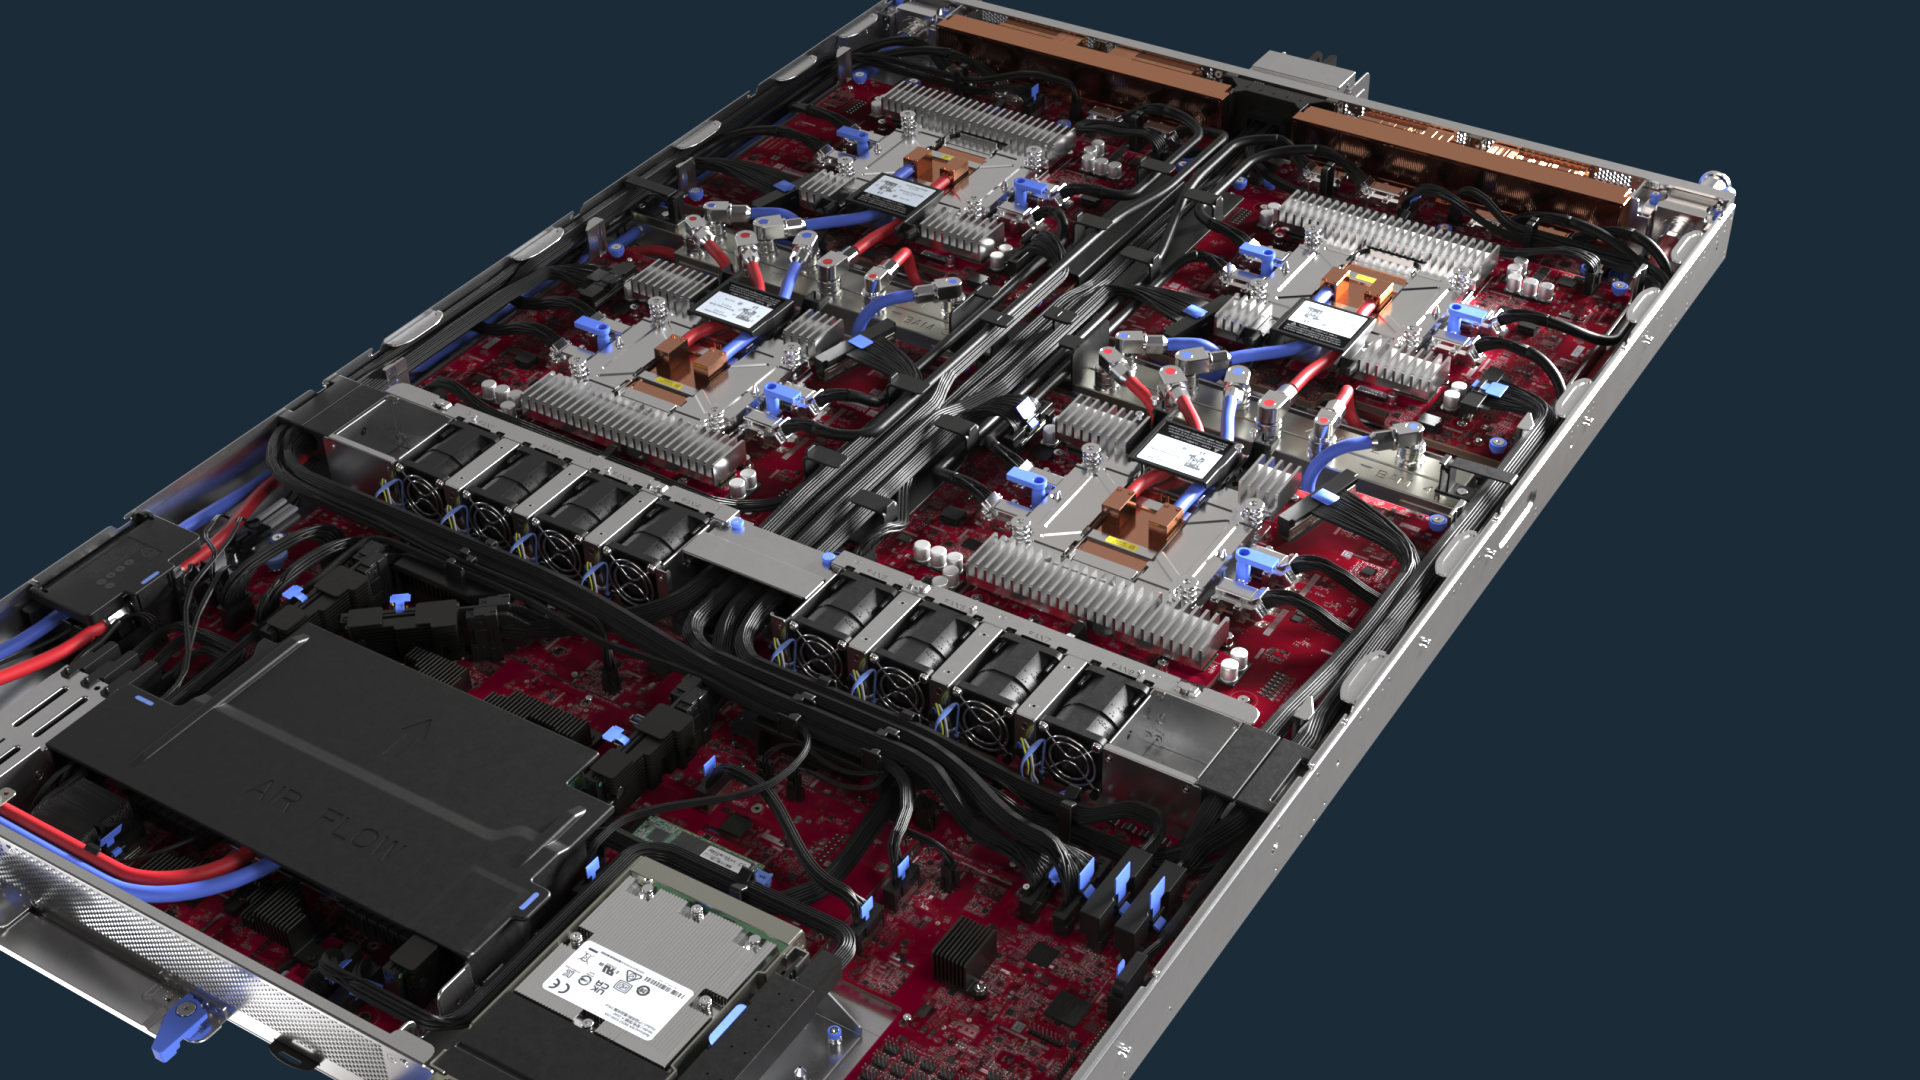
Uma resposta de IA parece apenas software na tela, mas depende de uma cadeia física: chips, memória, redes, energia e refrigeração. Quando essa infraestrutura muda, os efeitos podem chegar ao preço, à velocidade e à capacidade dos serviços usados por empresas de software.
Em 12 de outubro de 2026, a Microsoft anunciou a expansão da família Azure Maia. O Maia 200 já opera cargas do Microsoft Copilot. GitHub Copilot e Microsoft Foundry devem entrar nesse caminho até o fim de 2026. A geração Maia 300 está prevista para começar a ser implantada em produção em 2027.
Por que a Microsoft está criando seus próprios chips
O Maia é um acelerador voltado à inferência, nome dado ao momento em que um modelo já treinado recebe um pedido e produz uma resposta. Essa etapa concentra boa parte do custo operacional de assistentes, copilotos e agentes.
A Microsoft afirma que o Maia 300 foi desenhado para tarefas com contexto longo, respostas sensíveis à latência e agentes que executam várias etapas. O sistema combina chip, memória, rede, software, rack e datacenter. A intenção é reduzir movimentação de dados e aproveitar melhor cada unidade de energia.
Segundo a empresa, o Maia 300 poderá entregar 40% mais tokens por megawatt que sistemas líderes baseados em GPU e até sete vezes a capacidade de geração de tokens por rack do Maia 200, na configuração completa com 96 aceleradores. São métricas divulgadas pela fabricante para uma infraestrutura que ainda chegará à produção. Elas não significam redução automática de 40% na fatura do cliente, nem respostas sete vezes melhores.
O que isso muda na prática para uma empresa de software
O primeiro efeito é estratégico. Microsoft, Google, Amazon e outros grandes provedores estão aproximando hardware, modelos e serviços de nuvem. Isso pode melhorar a eficiência dos produtos, mas também aumenta a importância de entender onde a aplicação ficará presa a recursos específicos do fornecedor.
- Custo: maior eficiência pode abrir espaço para preços melhores ou limites mais amplos, mas a empresa deve acompanhar o valor cobrado por chamada e por fluxo concluído.
- Latência: agentes com várias etapas podem responder mais rápido se o provedor reduzir gargalos de memória e comunicação. O indicador útil é o tempo percebido pelo usuário, não a velocidade nominal do chip.
- Capacidade: mais memória e largura de banda favorecem contextos extensos e mais sessões simultâneas. Isso não elimina a necessidade de selecionar apenas os dados relevantes.
- Portabilidade: aplicações construídas sobre APIs e padrões bem definidos podem trocar modelos ou regiões com menos esforço. Otimizações exclusivas precisam justificar o custo de dependência.
Um teste que traduz infraestrutura em resultado
Considere uma empresa que usa o Microsoft Foundry para um agente de suporte. O fluxo consulta a base de conhecimento, verifica dados do chamado, sugere uma solução e encaminha casos críticos para uma pessoa. A mudança de infraestrutura só tem valor se esse processo melhorar.
MATERIAL PRÁTICO
Quer aplicar IA no seu trabalho?
Tenha acesso gratuito a 50 prompts prontos para usar e adaptar.
Quero acessar os promptsO piloto pode repetir um conjunto fixo de chamados e medir quatro pontos: custo total por caso, tempo até a resposta, percentual de tarefas concluídas corretamente e quantidade de intervenções humanas. Também vale registrar indisponibilidades, variação entre regiões e dificuldade para migrar o fluxo para outro modelo.
Essa avaliação evita dois erros comuns: escolher tecnologia apenas por benchmark do fabricante ou ignorar ganhos reais porque a mudança acontece longe da aplicação. O hardware importa quando altera a experiência, a margem ou a confiabilidade do produto.
Eficiência não substitui arquitetura
Mesmo com chips mais eficientes, contextos enormes continuam custando processamento. Uma empresa de software deve manter regras de roteamento: tarefas simples usam modelos menores; fluxos complexos recebem mais contexto; resultados repetidos podem aproveitar cache; ações críticas exigem confirmação e trilha de auditoria.
Para agentes conectados a ferramentas empresariais, permissões e qualidade dos dados permanecem decisivas. A infraestrutura consegue executar mais rápido, mas não corrige documentação desatualizada, acesso excessivo ou critérios vagos. A análise sobre a integração de Jira e Confluence com ChatGPT e Codex mostra como o contexto precisa ser acompanhado por controles e medição.
A ação recomendada agora
Não há motivo para redesenhar uma aplicação por causa de um chip previsto para 2027. Há, porém, um bom motivo para revisar a forma de medir IA. Troque indicadores genéricos, como número de mensagens ou tokens, por custo e qualidade do processo concluído. Mantenha uma camada de integração que permita comparar modelos e provedores.
Quando os ganhos do Maia chegarem ao Microsoft Foundry, GitHub Copilot ou outros serviços, a empresa terá uma base objetiva para decidir se a mudança melhora seu produto — e não apenas a infraestrutura do fornecedor.
Referências
- Microsoft — expansão do Azure Maia e Maia 300, 12 de outubro de 2026.
- Microsoft Azure — arquitetura do Maia 300, 12 de outubro de 2026.
- Microsoft — Maia 200: acelerador voltado à inferência, 26 de janeiro de 2026.
Imagem de capa: Microsoft — material de imprensa do Azure Maia 300.
PRÓXIMO PASSO
Leve esta ideia para a prática
Tenha acesso gratuito a 50 prompts para gestão, suporte, vendas, desenvolvimento, produto e implantação.
Quero acessar os prompts